Agents Are the Easy Part: The Harness Behind an AI Sales TeamAgentes São a Parte Fácil: O Harness por Trás de um Time de Vendas de IA
At RBBT we build an AI that sells through conversation. It answers customers of e-commerce brands on WhatsApp and web chat, recommends products, builds carts, sends checkout links and handles post-sale questions. When I explain it, people usually ask about the prompt.
The prompt is the smallest part of the system. A frontier model already knows how to talk. What it doesn't know is:
- which brand it is speaking for;
- what this customer bought last month;
- which actions it is allowed to take;
- when to stop and call a person;
- who answers for the result.
Everything that supplies those answers is what I call the harness: the structure around the model.
This post is about that harness: its agents, its memory, the cycles it runs on, the way it makes decisions, and what production taught us. It is not a recipe. It is the reasoning behind the shape.
Boundaries before agents
The first decision was to design the domain before designing any agent. A sales conversation is not one job. It spans several areas, each with its own vocabulary and its own failure modes:
- working out who is talking;
- understanding what they want;
- recommending;
- closing an order;
- answering questions about an order that already exists.
Each of these became a bounded capability with its own language, data and tools, and every agent lives inside exactly one of them. That is the difference between a native agent and a chatbot with many tools: the boundary comes first, and the agent inherits its scope from it.
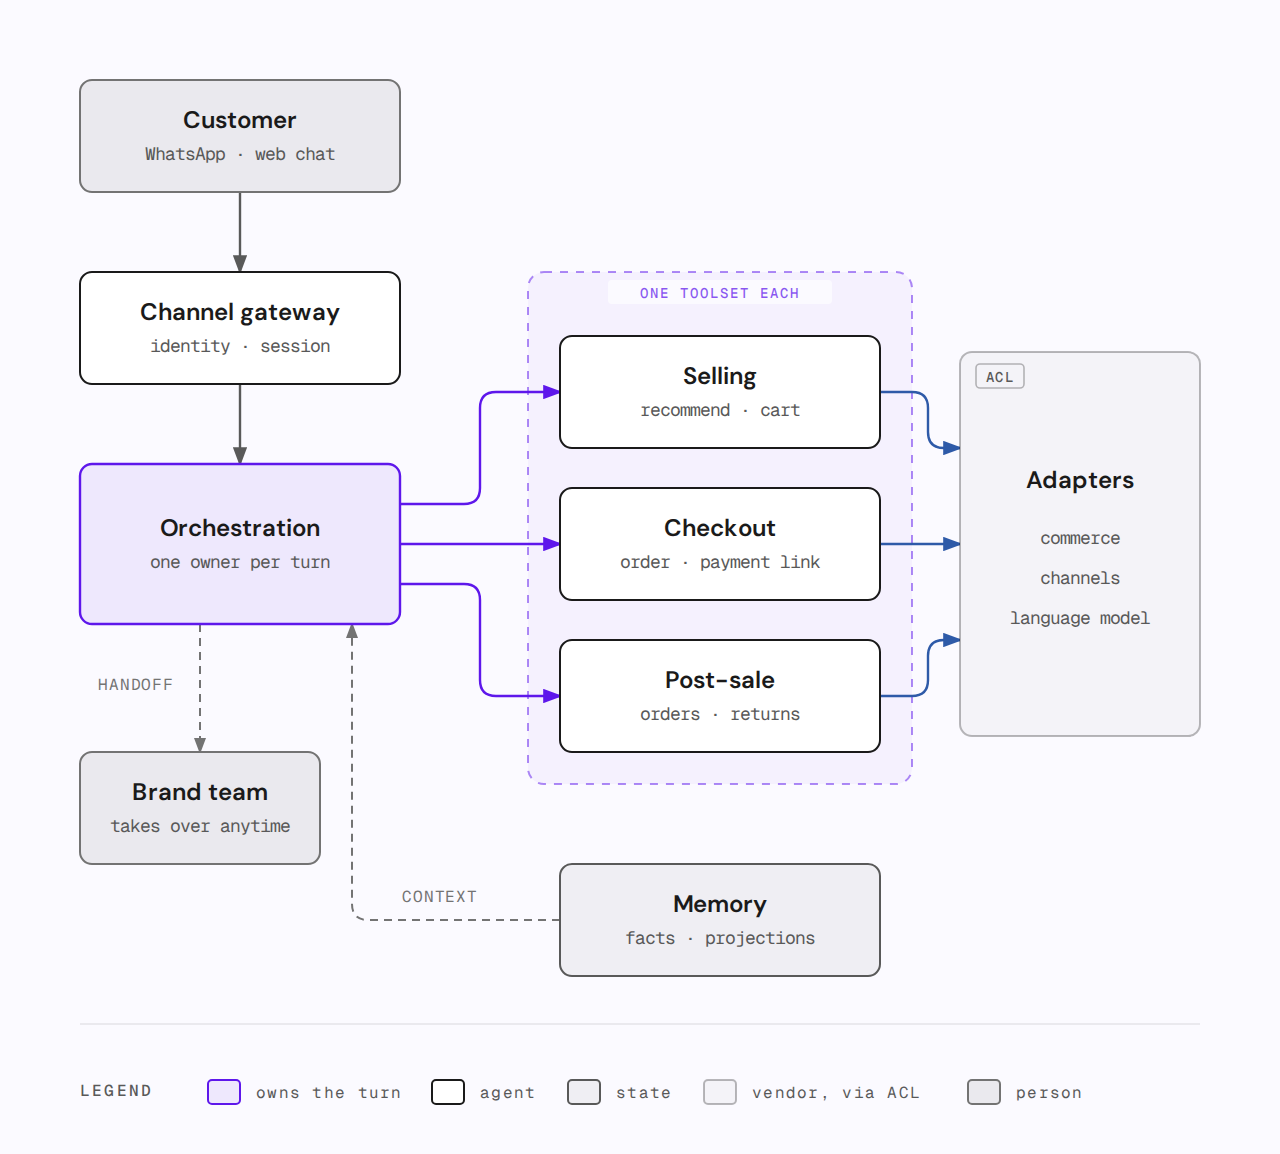
A few consequences of that shape:
One owner per turn. Orchestration reads each incoming message and hands the turn to exactly one agent. A committee never answers the customer.
Least privilege. The selling agent builds carts and the post-sale agent looks up orders, and neither carries the other's tools. If one of them misbehaves, the damage stays inside its own capability.
Vendors stay outside. Commerce platforms, messaging channels and even the language model sit behind anti-corruption layers. The same selling logic runs on Shopify and Nuvemshop, and replacing a provider means changing an adapter, not rewriting the core.
A human is a first-class path. When the system is uncertain, blocked or asked for something sensitive, it hands the conversation to the brand's team, with context. Escalation is the safe default, not an error state.
Memory: facts first, context last
The naive approach to memory is to stuff the chat history into the prompt. It breaks quickly:
- it is expensive;
- it leaks data from one purpose into another;
- the model treats a rumor and a fact the same way.
We treat memory as a pipeline that starts with facts. Orders, the products a customer looked at, tags from conversations and the brand's catalog are recorded as they happen. Background jobs turn those facts into projections:
- what the person bought, and in which variations;
- what they saw and didn't buy;
- how this brand names its sizes and colors.
Only at the last step, on every turn, does a composer build a short context block for the agent that owns the turn.
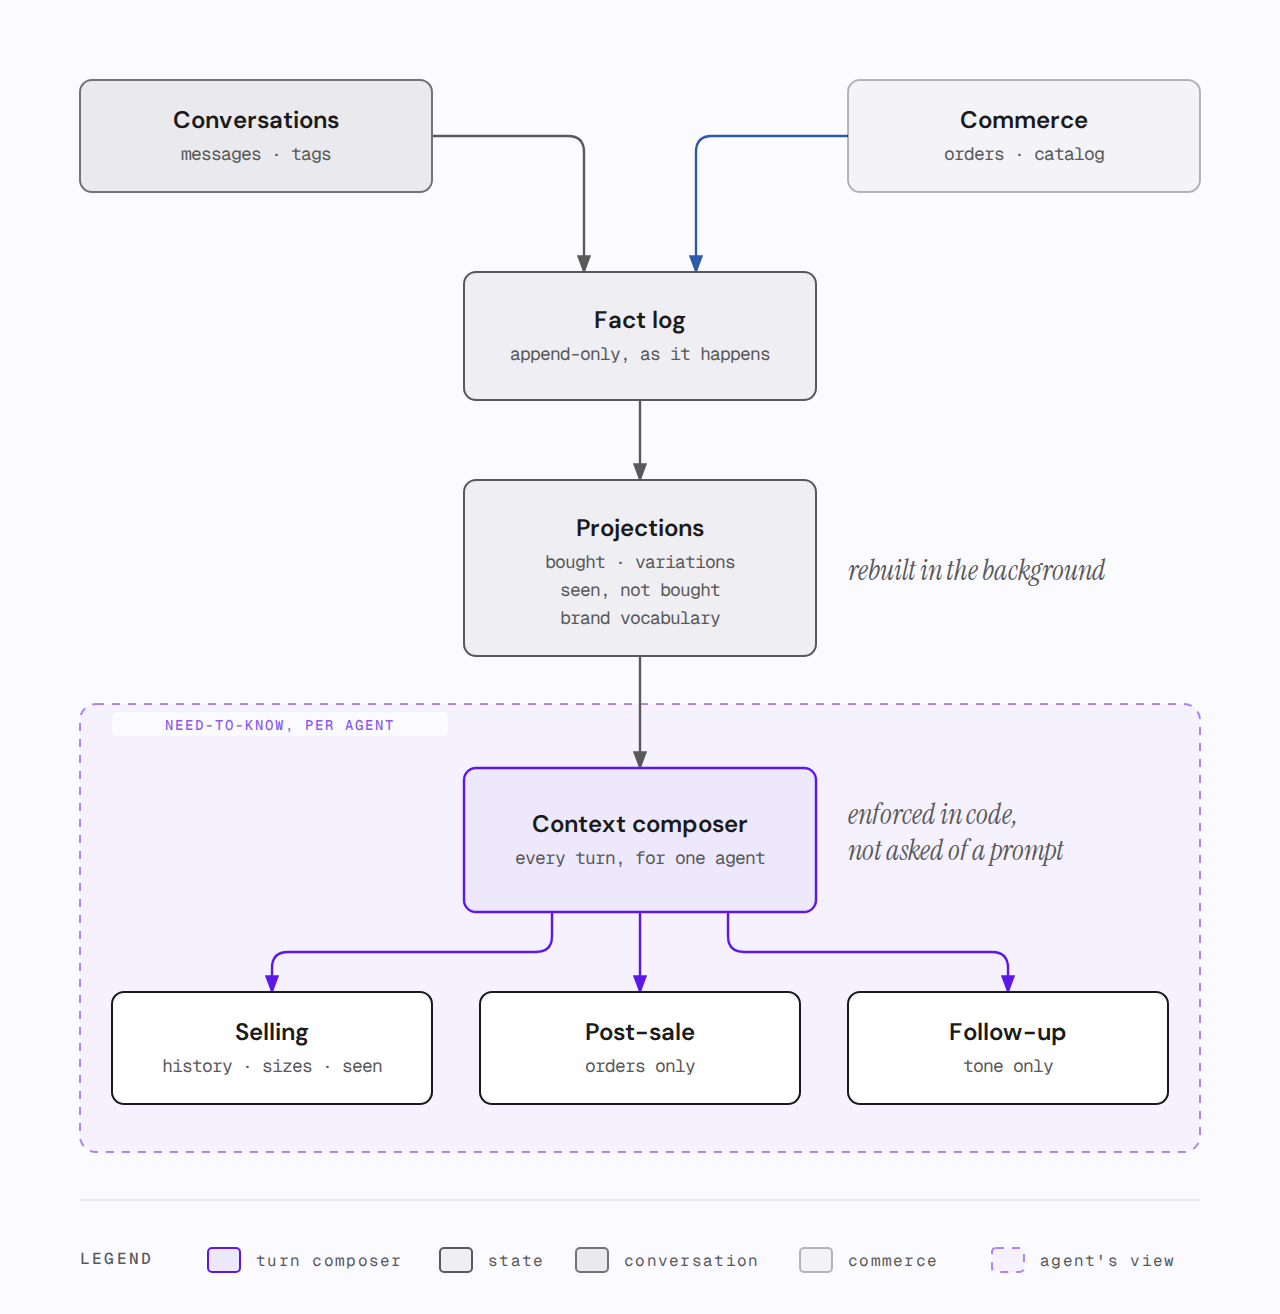
That last step holds the most important rule: need-to-know, per agent.
- The selling agent sees the history it needs to recommend well.
- The post-sale agent sees orders and nothing else.
- A follow-up message gets only the tone of the relationship.
This is enforced in code, not requested in a prompt.
Two details I'm proud of:
Language is memory too. Every brand names things differently. The system learns each brand's vocabulary from its own catalog and speaks it back, instead of forcing a generic taxonomy on the customer.
Privacy is a design input. Brazil's data protection law (LGPD) shaped the pipeline from the start, and the DPO reviews and ratifies decisions about personal data before they ship. For example, to discuss an order the customer proves it is theirs with an e-mail and an order number. The agent never "confirms" an order by echoing back its date or value. That shortcut would have been convenient: we built it, measured it, and deliberately kept it switched off.
Four clocks
A harness is not only structure; it is timing. Ours runs on four clocks. Each is slower than the one before it, and each protects the faster ones.
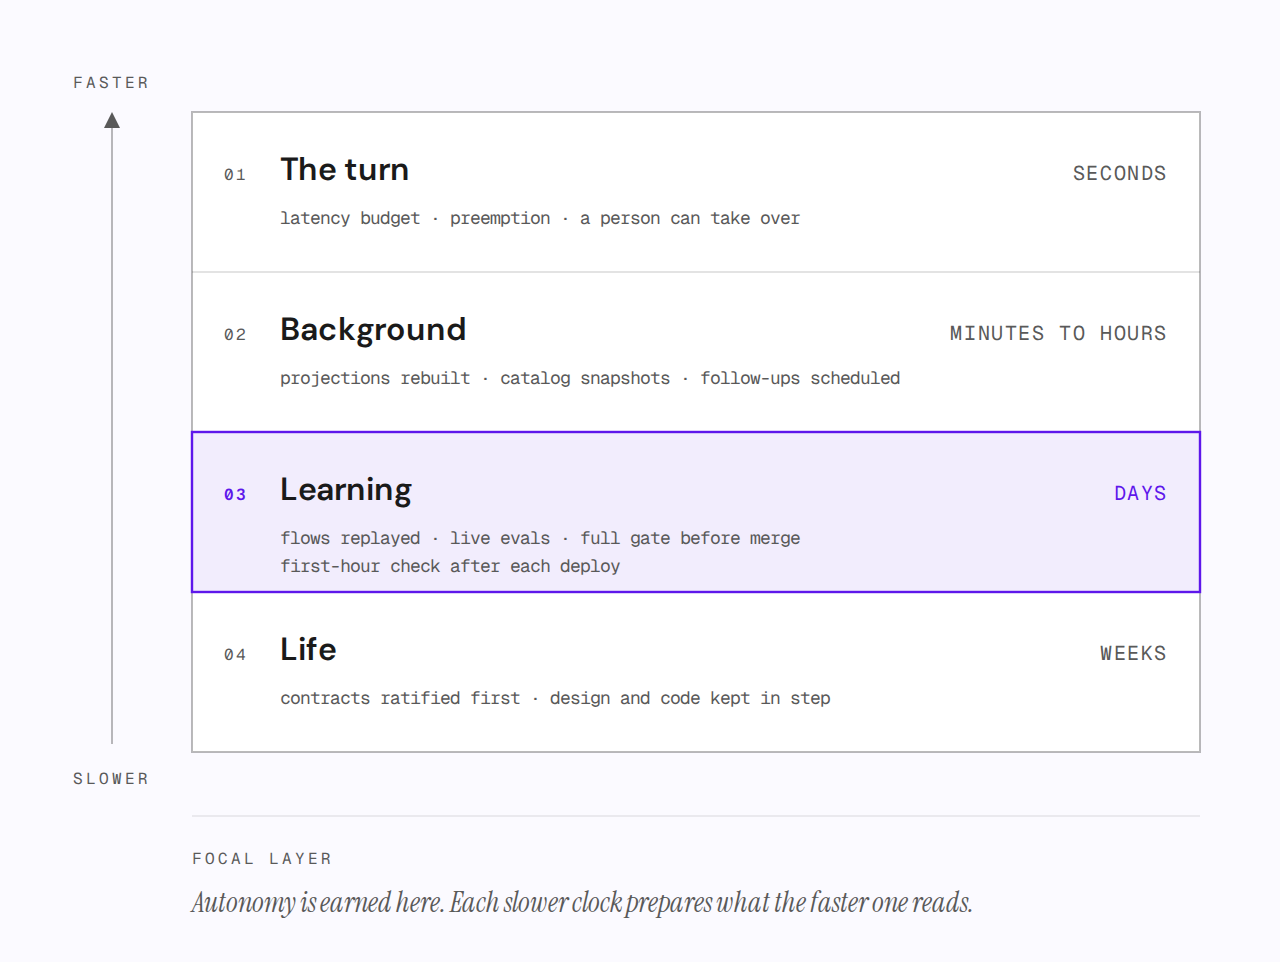
The turn (seconds). A turn has a latency budget. If the customer sends another message mid-turn, the turn in flight can be preempted instead of answering a question that is already out of date. The brand's team can take over a conversation at any moment.
Background (minutes to hours). Projections are rebuilt, catalogs are snapshotted and follow-ups are scheduled. Everything a turn reads is prepared ahead of time, so the turn itself stays fast and predictable.
Learning (days). Evaluation is infrastructure, not a phase.
- Real flows are replayed against new versions.
- Live evaluations run with pinned settings.
- We track routing accuracy, recommendation quality and conversion.
- Nothing merges without the full gate: hermetic test suites, architecture guards and boundary checks.
- After a deploy, a first-hour check compares production signals with what we expected.
Life (weeks). The slowest clock keeps the design and the code from drifting apart. Contracts between capabilities are frozen before anyone builds against them. When reality disagrees, the contract is amended and ratified first, and the code follows. A guard fails the build when the design says one thing and the code does another.
The principle behind all four: observability comes before autonomy. Each step of autonomy is earned with measurements, and the measurements keep running after it is earned.
Decisions are artifacts
The part of the harness that surprises people most is how much of it is written down. Sales alone has more than a hundred decision records, plus product requirement documents and versioned contracts with a ratification log. Each decision has an owner, a date and a reason.
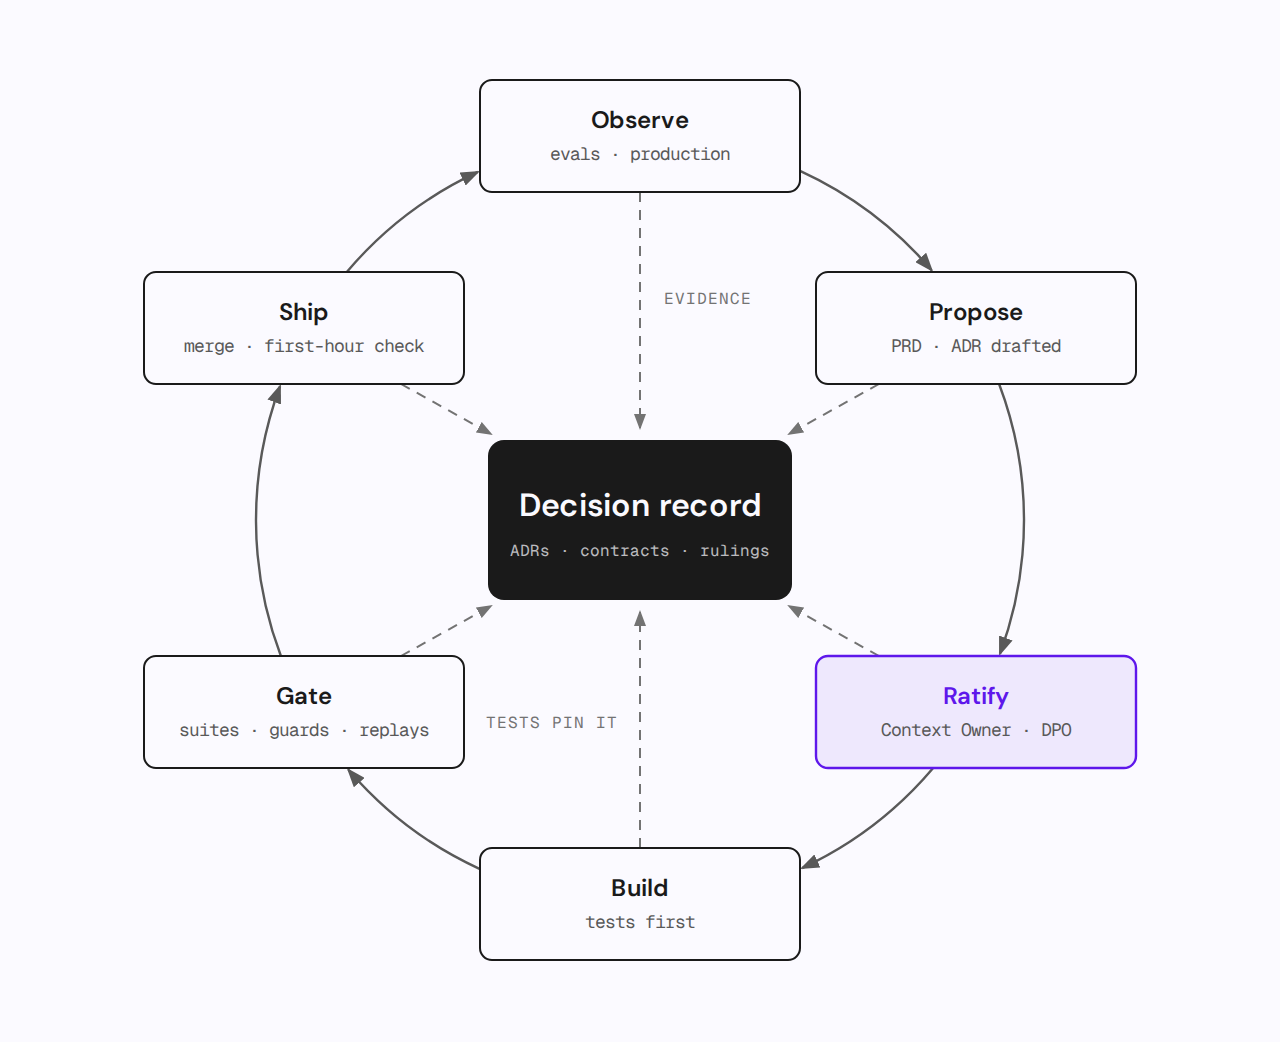
Three ideas make this work:
Agents propose, people ratify. Every capability has a named human owner, the Context Owner, who ratifies product decisions; the DPO ratifies anything that touches personal data. Agents are classified by autonomy tier (read-only, suggest, act-with-review, autonomous) and move between tiers only on evidence.
Decisions can ship dormant. Engineering often moves faster than ratification. Instead of blocking one on the other, we ship the capability behind a flag that holds the decision until it is ratified. The code is ready, and the decision is not rushed.
Tests pin decisions. Once a decision is ratified, a test encodes it. Changing the behavior later means changing the test on purpose, with the new ruling recorded next to it.
When someone asks "why does it work like this?", the answer is a link, not a meeting. That is what lets a small team change a complex system without re-deciding it every quarter.
What production taught us
Most of the harness exists because something in production pushed back. These are the findings, bottlenecks and numbers that shaped it.
Perceived latency beats measured latency. We used to send a quick "just a moment" while the real answer was being prepared. In production it became the most visible part of the wait. At the median, the acknowledgment arrived about ten seconds in and was followed by another 26 seconds of silence, and three out of four used the same formula. We replaced it with one grounded line, written by the agent that owns the answer and sent only when it is about to call a slow tool. Every outgoing message is now tagged by what it is (bridge, final answer, escalation), so latency is measured from the customer's side, not the server's.
Customers type in bursts. Three short messages in a row are usually one question. A fixed window anchored on the first message either cut people off or kept quick customers waiting. Now the turn starts when the customer stops typing, with a hard ceiling so nobody waits forever.
Every message has a price. Since WhatsApp started billing service messages one by one, a reply split into bubbles costs per bubble. Production replies averaged 2.8 bubbles, with 5 at the 95th percentile. Answering first and merging the rest brought our evaluation set to one bubble per reply, 64% fewer messages, with every case still conformant and nothing cut from the content.
Failure needs a floor. About 0.8% of turns fail to produce an answer, often because the model provider is the thing that failed. The customer never gets silence: a fallback written without the model keeps the promise, and the brand team is alerted.
Metrics can lie too. Once, a queue-age gauge reported a follow-up job waiting almost eight hours on an idle lane, and a critical alert kept firing for hours. The queue library resets a delayed job's delay when the job becomes ready, and the gauge never cleared. Now the sampler keeps its own clock, reads zero when nothing waits, and the alert needs real waiting work. Observability before autonomy applies to the dashboards too.
None of these fixes was a better prompt. Each one was a change to the harness: a new boundary, a new clock, a decision written down and pinned by a test. That is where the product's performance actually lives.
Na RBBT construímos uma IA que vende pela conversa. Ela atende clientes de marcas de e-commerce no WhatsApp e no chat do site, recomenda produtos, monta carrinhos, envia links de checkout e cuida das dúvidas de pós-venda. Quando eu explico isso, as pessoas costumam perguntar sobre o prompt.
O prompt é a menor parte do sistema. Um modelo de ponta já sabe conversar. O que ele não sabe é:
- para qual marca está falando;
- o que esse cliente comprou no mês passado;
- quais ações ele pode tomar;
- quando parar e chamar uma pessoa;
- quem responde pelo resultado.
Tudo o que fornece essas respostas é o que eu chamo de harness: a estrutura em volta do modelo.
Este post é sobre esse harness: seus agentes, sua memória, os ciclos em que ele roda, a forma como ele toma decisões e o que a produção nos ensinou. Não é uma receita. É o raciocínio por trás do formato.
Limites antes dos agentes
A primeira decisão foi desenhar o domínio antes de desenhar qualquer agente. Uma conversa de vendas não é um trabalho só. Ela passa por várias áreas, cada uma com seu próprio vocabulário e seus próprios modos de falha:
- descobrir quem está falando;
- entender o que a pessoa quer;
- recomendar;
- fechar um pedido;
- responder dúvidas sobre um pedido que já existe.
Cada uma delas virou uma capacidade delimitada, com linguagem, dados e ferramentas próprios, e cada agente vive dentro de exatamente uma delas. Essa é a diferença entre um agente nativo e um chatbot com muitas ferramentas: o limite vem primeiro, e o agente herda dele o seu escopo.
Algumas consequências desse formato:
Um dono por turno. A orquestração lê cada mensagem que chega e entrega o turno a exatamente um agente. Nunca é um comitê que responde ao cliente.
Privilégio mínimo. O agente de vendas monta carrinhos e o agente de pós-venda consulta pedidos, e nenhum carrega as ferramentas do outro. Se um deles errar, o estrago fica dentro da sua própria capacidade.
Fornecedores ficam do lado de fora. Plataformas de commerce, canais de mensagem e até o modelo de linguagem ficam atrás de camadas anticorrupção. A mesma lógica de venda roda na Shopify e na Nuvemshop, e trocar um fornecedor significa trocar um adaptador, não reescrever o núcleo.
Um humano é um caminho de primeira classe. Quando o sistema está em dúvida, travado ou recebe um pedido sensível, ele passa a conversa para o time da marca, com contexto. Escalar é o padrão seguro, não um estado de erro.
Memória: fatos primeiro, contexto por último
O jeito ingênuo de lidar com memória é enfiar o histórico do chat no prompt. Isso quebra rápido:
- é caro;
- vaza dados de um propósito para outro;
- o modelo trata um boato e um fato do mesmo jeito.
Nós tratamos a memória como um pipeline que começa nos fatos. Pedidos, os produtos que o cliente olhou, as tags das conversas e o catálogo da marca são registrados no momento em que acontecem. Jobs em segundo plano transformam esses fatos em projeções:
- o que a pessoa comprou, e em quais variações;
- o que ela viu e não levou;
- como essa marca chama seus tamanhos e cores.
Só no último passo, a cada turno, um compositor monta um bloco curto de contexto para o agente dono do turno.
É nesse último passo que mora a regra mais importante: cada agente sabe só o que precisa.
- O agente de vendas vê o histórico de que precisa para recomendar bem.
- O agente de pós-venda vê os pedidos e mais nada.
- Uma mensagem de follow-up recebe só o tom da relação.
Isso é garantido no código, não pedido num prompt.
Dois detalhes de que me orgulho:
Linguagem também é memória. Cada marca chama as coisas de um jeito. O sistema aprende o vocabulário de cada marca a partir do próprio catálogo e fala do mesmo jeito, em vez de impor uma taxonomia genérica ao cliente.
Privacidade é um insumo de design. A LGPD moldou o pipeline desde o início, e o DPO revisa e ratifica as decisões sobre dados pessoais antes de irem ao ar. Por exemplo, para falar de um pedido, o cliente prova que ele é seu com o e-mail e o número do pedido. O agente nunca "confirma" um pedido repetindo a data ou o valor. Esse atalho seria conveniente: nós o construímos, medimos e deixamos desligado de propósito.
Quatro relógios
Um harness não é só estrutura; é também tempo. O nosso roda em quatro relógios. Cada um é mais lento que o anterior, e cada um protege os mais rápidos.
O turno (segundos). Um turno tem um orçamento de latência. Se o cliente manda outra mensagem no meio do turno, o turno em andamento pode ser interrompido, em vez de responder a uma pergunta que já ficou para trás. O time da marca pode assumir uma conversa a qualquer momento.
Segundo plano (minutos a horas). As projeções são reconstruídas, os catálogos ganham snapshots e os follow-ups são agendados. Tudo o que um turno lê é preparado com antecedência, para que o turno em si continue rápido e previsível.
Aprendizado (dias). Avaliação é infraestrutura, não uma fase.
- Fluxos reais são reexecutados contra as novas versões.
- Avaliações ao vivo rodam com configurações fixadas.
- Acompanhamos a precisão do roteamento, a qualidade das recomendações e a conversão.
- Nada entra sem passar pelo portão completo: suítes de teste herméticas, guardas de arquitetura e checagens de limites.
- Depois de um deploy, uma checagem da primeira hora compara os sinais de produção com o que esperávamos.
Vida (semanas). O relógio mais lento impede que o design e o código se afastem. Os contratos entre capacidades são congelados antes que alguém construa em cima deles. Quando a realidade discorda, o contrato é emendado e ratificado primeiro, e o código vem depois. Uma guarda quebra o build quando o design diz uma coisa e o código faz outra.
O princípio por trás dos quatro: observabilidade vem antes da autonomia. Cada passo de autonomia é conquistado com medições, e as medições continuam rodando depois que ele é conquistado.
Decisões são artefatos
A parte do harness que mais surpreende as pessoas é o quanto dele está escrito. Só o Sales tem mais de cem registros de decisão, além de documentos de requisitos de produto e contratos versionados com um registro de ratificações. Cada decisão tem um dono, uma data e um motivo.
Três ideias fazem isso funcionar:
Agentes propõem, pessoas ratificam. Cada capacidade tem um dono humano nomeado, o Context Owner, que ratifica as decisões de produto; o DPO ratifica tudo o que toca dados pessoais. Os agentes são classificados por nível de autonomia (somente leitura, sugere, age com revisão, autônomo) e só mudam de nível com evidência.
Decisões podem ir ao ar adormecidas. A engenharia costuma andar mais rápido que a ratificação. Em vez de travar uma pela outra, a capacidade vai ao ar atrás de uma flag que segura a decisão até ela ser ratificada. O código fica pronto, e a decisão não é tomada às pressas.
Testes prendem as decisões. Depois que uma decisão é ratificada, um teste a codifica. Mudar o comportamento depois significa mudar o teste de propósito, com a nova decisão registrada ao lado.
Quando alguém pergunta "por que funciona assim?", a resposta é um link, não uma reunião. É isso que permite a um time pequeno mudar um sistema complexo sem redecidir tudo a cada trimestre.
O que a produção nos ensinou
A maior parte do harness existe porque algo em produção reagiu. Estes são os achados, os gargalos e os números que o moldaram.
A latência percebida pesa mais que a medida. Nós mandávamos um rápido "só um momento" enquanto a resposta de verdade era preparada. Em produção, isso virou a parte mais visível da espera. Na mediana, o aviso chegava por volta de dez segundos depois e vinha seguido de mais 26 segundos de silêncio, e três em cada quatro usavam a mesma fórmula. Trocamos por uma única linha concreta, escrita pelo agente dono da resposta e enviada só quando ele está prestes a chamar uma ferramenta lenta. Toda mensagem que sai agora é marcada pelo que ela é (ponte, resposta final, escalonamento), para que a latência seja medida do lado do cliente, não do servidor.
Clientes digitam em rajadas. Três mensagens curtas seguidas costumam ser uma pergunta só. Uma janela fixa ancorada na primeira mensagem ou cortava as pessoas no meio, ou deixava esperando quem era rápido. Agora o turno começa quando o cliente para de digitar, com um teto rígido para que ninguém espere para sempre.
Toda mensagem tem um preço. Desde que o WhatsApp passou a cobrar as mensagens de atendimento uma a uma, uma resposta quebrada em vários balões custa por balão. Em produção, as respostas tinham em média 2,8 balões, com 5 no percentil 95. Responder primeiro e juntar o resto levou nosso conjunto de avaliação a um balão por resposta, 64% menos mensagens, com todos os casos ainda conformes e nada cortado do conteúdo.
A falha precisa de um chão. Cerca de 0,8% dos turnos não conseguem gerar uma resposta, muitas vezes porque quem falhou foi o próprio provedor do modelo. O cliente nunca fica no silêncio: uma mensagem reserva, escrita sem o modelo, cumpre a promessa, e o time da marca é alertado.
Métricas também mentem. Uma vez, um medidor de idade da fila acusou um job de follow-up esperando quase oito horas numa fila ociosa, e um alerta crítico ficou disparando por horas. A biblioteca de filas zera o atraso de um job agendado quando ele fica pronto, e o medidor nunca era zerado. Agora o amostrador mantém o próprio relógio, marca zero quando nada está esperando, e o alerta só dispara com trabalho de fato esperando. Observabilidade antes da autonomia vale para os painéis também.
Nenhuma dessas correções foi um prompt melhor. Cada uma foi uma mudança no harness: um novo limite, um novo relógio, uma decisão escrita e presa por um teste. É aí que o desempenho do produto realmente mora.